
 2026年11月08日
文/(作者) 京都精华大学 姚捷鑫
内容提要
本文以 AI 生成音乐短片《圆满》的无障碍改编为个案,讨论视听内容面向视障群体的可及性问题。音乐短片的改编面临“叙事空隙稀缺”与“音乐本体不可让渡”的双重矛盾,传统口述影像的做法难以直接套用;人工智能辅助的生产方式为破解这一矛盾提供了一条低成本路径。更值得讨论的是,当内容可以低成本地“重做一遍”,为不同的人准备不同的版本,就从公益理想变成了可行的生产方式。
关键词:信息无障碍;口述影像;作者口述影像;
一、问题的提出:无障碍的”最后一公里”
笔者做了一个关于《圆满》的短视频作品,作品以歌曲《圆满》的音乐为背景,以十五月圆之夜,人间期盼团圆为主题,通过阐述对“天上常有月圆,人间难得圆满”的思考,表达面对人世间的悲欢离合、艰辛坎坷,珍惜拥有、感恩遇见就是圆满、就是幸福的人生理念。这样的一个音乐短片作品如何通过二创做成一个让视障群体也能够理解的作品呢?通俗地讲,就是把一个音乐视频短片的画面遮住,只听声音,能否充分理解作品所能表达的思想内涵。作品配的BGM,,从头唱到尾的是歌曲,但屏幕上同时发生着很多事:有人在欢声笑语,有人在伤心落泪,有人在觥筹交错,有人在雨夜奔波。这些,声音不会告诉你,对视障者而言,内容仍然是“沉默”的:听得见配乐与对白,却不知道画面里发生了什么。如何通过AI手段,用口述讲解的方式让视障人士也能“看到”画面。
2023 年起施行的《无障碍环境建设法》把信息无障碍写成了明确的义务[1]。《残疾人保障法》(2008 年修订)写进了要为影视节目增加字幕或解说的要求[2],但就平台上的短视频和音乐短片而言,配有口述影像的作品仍然较少。根据估算,中国的视障人士超过一千七百万,硬件层面的障碍正在逐步减少,盲道在铺设,应用在做读屏适配。而没有口述影像的视频,对盲人观众来说就是不存在的,这就是信息无障碍的“最后一公里”:不是让人去够内容,而是让内容够到人。本文讨论的,正是这一公里难在哪里,以及人工智能正在怎样改变它的长度。
二、理论背景:口述影像与“内容适配人”
为视障观众讲述画面,国际通行的方法是口述影像(Audio Description),按通行的界定,它是在影视作品原有的声音与对白的间隙中,以简洁客观的语言描述关键视觉信息的媒介转换行为,也就是把“看见”翻译成“听见”。学界通常把它归入视听翻译,从认知过程、能力要素和传播效应看,它更接近口译。
它不是对作品的复述,而是一种受严格约束的二次创作。口述影像的一种思路是用中立、客观的语言,只描述可观察的事实,不替观众判断情绪。而另一种思路,叫“作者口述影像”,由导演来主导,描述不必回避主观色彩,力求贴近创作者的意图。
在设计思路上,可以区分两种路径。通用设计主张产品从一开始就容纳尽可能多样的人,追求一个版本服务所有人;“内容适配人”则承认不同的人需要不同的版本:视障观众需要带描述的版本,听障观众需要带声音提示的版本,老年观众需要节奏较慢的版本。与之相对,目前常见的是“人适配内容”,即边缘群体付出额外的努力,去适应一个并非为他们设计的内容。“内容适配人”长期受限于成本:一部电影制作一版口述影像,需要多个环节的专业协作;公益机构只能以志愿方式勉强支撑,数量庞大的短视频则难以顾及。这一模式能否成立,前提是“适配”的成本足够低,这正是本文要探讨的问题。
三、个案:一分四十四秒的沉默
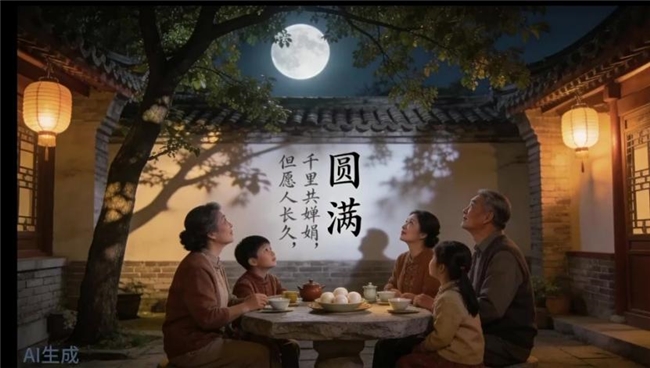
图 1 《圆满》片头
《圆满》是笔者做的一部 AI 生成音乐短片,两分五十八秒,以中秋为背景,用一首完整的歌串起一群人:围桌吃饭的一家人、老街的红灯笼、雨夜提兔子灯的女孩,还有深夜的骑手和值班的医生。全片没有一句对白,是检验“音乐内容无障碍”的极端样本。
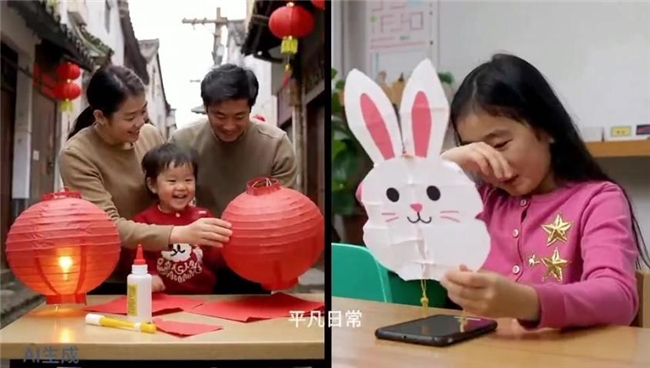
以图 2为例,这一画面的字幕只有一句歌词。视障观众无法获知的是:分屏左侧,一家三口围坐桌前,孩子举着灯笼,笑容明朗;右侧是一名留守儿童,面对手机屏幕里的父母照片出神,手中握着半盏破损的兔子灯,抬手擦拭泛红的眼眶。两侧画面形成冷暖对照,呈现同一个节日里不同家庭的处境。这种情绪反差只能依靠画面传达,仅靠听觉无法获得。
对音轨逐段检查后发现:全片可插入描述的自然停顿只有十一处,约二十五秒;而从一分十二秒到片尾,是一段一分四十四秒的连续唱段,没有任何可以开口的空当。这是音乐短片区别于剧情片的根本不同:剧情片的声音为叙事服务,可以让路;音乐短片里,音乐本身就是内容,让路即毁坏。“见缝插针”的经典方法在此失去了前提。
最后的解法是妥协:在唱段里插描述,同时让音乐在每条描述出现的一两秒里后退,说完立刻恢复。这并没有消除前述矛盾,只是把对音乐的干扰降到最低。全片共插入二十六条描述,累计约四十八秒,其中十一条放在自然停顿里,十五条放在唱段里,全部由语音合成配音完成。对无障碍而言,衡量的不是分贝,而是一个具体的事实:视障观众有可能独立、完整地“看完”一部片子,而不必请人坐在旁边替自己复述。
四、讨论:当AI让“重做一遍”变得便宜
这个个案真正值得注意的不是技术,而是成本结构的变化。传统生产中,撰稿要逐帧看片,配音要真人进棚,对时与混音需要专业设备和经验;而在本个案里,配音由语音合成完成,时间轴由程序测算,混音由程序按“听不听得清”逐句调整——一个学生、一台电脑、半天时间,完成了过去需要团队协作数日的工作。
当“重做一遍”变得便宜,“内容适配人”就从理想变成可规模化的生产方式:同一部影片,可以有面向视障者的口述版、面向听障者的字幕增强版、面向老年观众的慢节奏版——内容不再是固定成品,而是可按需分化的形态。但有两个问题需要注意,一是AI 降低的是执行成本,不是判断成本:哪一秒值得描述、谁的故事该被讲述,仍依赖人对作品的理解,技术负责“说得出”,人负责“说得对”。其二合成语音能稳定传达信息,却难以传递停顿与叹息等情感表达,高质量版本仍需人声参与。
五、社会实践意义:从个案到行业
在制度层面,法律已经规定了视听内容传达的无障碍义务,但义务的落实需要可负担起的生产路径,若始终依赖志愿生产,义务将最终悬空,AI 辅助的轻量流程为义务可履行提供了技术前提,让“做得起”成为可能。
在行业层面,要改的不是某一部作品,而是流程:无障碍应该放在创作的开头,而不是收尾时补的一道工序。写第一版脚本时就问一句:如果一个人只能听,他跟得上吗?
在文化权利层面,《残疾人权利公约》确认了残障者平等参与文化生活的权利[3]。这种平等最终落在具体的观看时刻上:当一位视障观众能独立看完一部讲述团圆的短片,他获得的不只是信息,而是作为平等主体的文化身份。
结语
一分四十四秒的沉默,是音乐短片无障碍改编的结构性难题,也是“内容适配人”必须跨越的门坎。本个案表明,生成式人工智能正在把这道门槛降下来:为不同的人定制不同的内容版本,第一次具备了规模化的现实条件。当然,判断与情感仍是人的领地。AI 影片学会“被听见”,改变的只是可能性;让残障用户真正平等地进入内容世界,仍取决于行业是否愿意把无障碍从收尾工序移到创作起点。当那一天到来,“圆满”就不再只是那这短片的片名。
参考文献:
[1] 《中华人民共和国无障碍环境建设法》(2023 年 9 月 1 日起施行)。
[2] 《中华人民共和国残疾人保障法》(2008 年修订)。
[3] 联合国《残疾人权利公约》(中国于 2008 年批准)。

